Гэтая старонка прысвечана як нараджаецца маўленне: канкатэнацыя кліпаў, параметрычныя вакадэры, неапрацаванае аўдыё ў стылі WaveNet і нейронныя мадэлі, якія GSpeech маршрутызуе сёння. Гэта не спіс «чаму дадаваць плэер» — ён працягвае жыць перавагі вэб-сайта TTSГэта таксама не пакрокавае кіраўніцтва па ўсталёўцы WordPress.
На сайце вы не выбіраеце даследчую працу. Вы выбіраеце голас у Cloud Console. У гэтым выбары... Уніфікаваны механізм штучнага інтэлекту для галасавога кіравання (камерцыйны) можна выкарыстоўваць OpenAI, Gemini, Google Cloud, Chirp3 HD, Neural2, Polyglot і WaveNet — ключы API не патрабуюцца. Воблачная апрацоўка, адсутнасць нагрузкі на сервер, захоўвае сінтэз па-за вашым паходжаннем.
Канвеер сінтэзу (што насамрэч адбываецца)
Сінтэз маўлення пераўтварае запісаныя токены ў форму хвалі. Прайгравальнік вэб-сайта — гэта толькі апошні крок: прайграванне файла. Цікавая праца пачынаецца раней.
- Тэкст уводу — ізаляваны артыкул, вылучаны прамежак (RHT) або перакладзены радок. Ізаляцыя — гэта праца над прадуктам, а не артыкул па вакадэры.
- Лінгвістычны аналіз — словы, націск, паўзы. Тут размешчаны псеўданімы разумнага вымаўлення: радкі брэндаў, якія мадэль інакш адгадала б.
- Акустычная мадэль - канкатэнацыя адзінак, параметрічны вакадэр або нейронная сетка, якая прадказвае гук.
- Выхад сігналу - захоўваецца адзін раз у раздзеле "Згенераваць адзін раз, захаваць і прайграваць", а затым трансліруецца ў браўзеры speechSynthesis прапускае гэтую краму і выкарыстоўвае тое, што пастаўлялася з АС.
Тры сямействы мадэляў TTS
Аб'яднаны тэкст на мове мовы захоўвае кароткія кліпы прамоўцаў і рэкамбінуе іх. Змена прамоўцы або эмоцыі звычайна азначае запіс новай базы дадзеных. Класічныя стэкі ў стылі Siri выкарыстоўвалі гэту ідэю.
Параметрычны тэкст на мове мовы захоўвае рысы маўлення ў параметрах мадэлі. Раннія версіі часта гучалі менш натуральна, чым канкатэнаваныя, таму што гук праходзіў праз вакадэр.
Нейронавыя сістэмы ляжаць на вяршыні гэтай гісторыі. Стэкі, заснаваныя на правілах і статыстычных дадзеных, дагэтуль існуюць у падручніках. Тое, што вы чуеце ў камерцыйных галасах GSpeech, — гэта сінтэз штучнага інтэлекту: OpenAI, Gemini, Google Cloud Neural2 / Polyglot / Chirp3 HD і WaveNet, а не лакальны канкатэнаваны банк на вашым PHP-хосце.
WaveNet: мадэляванне неапрацаванай формы хвалі
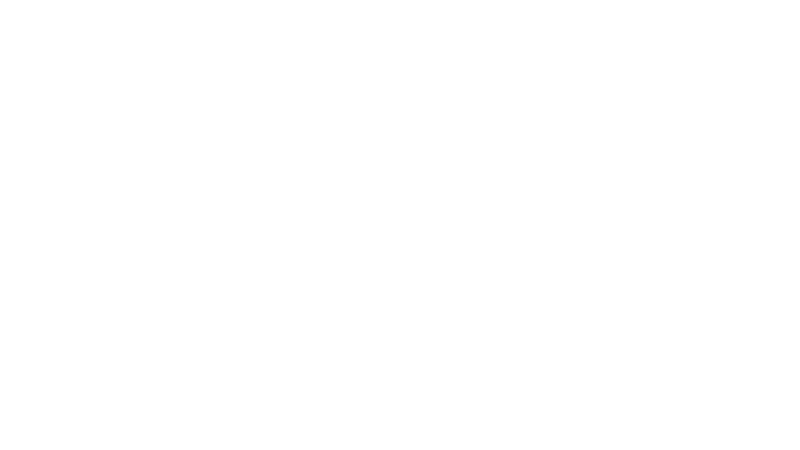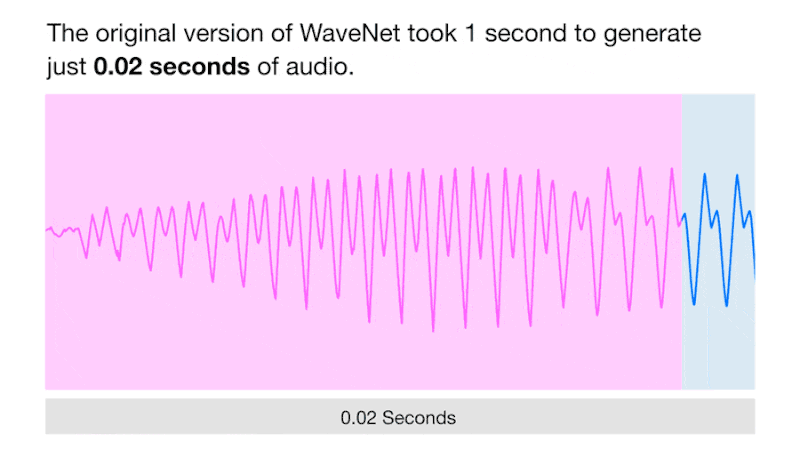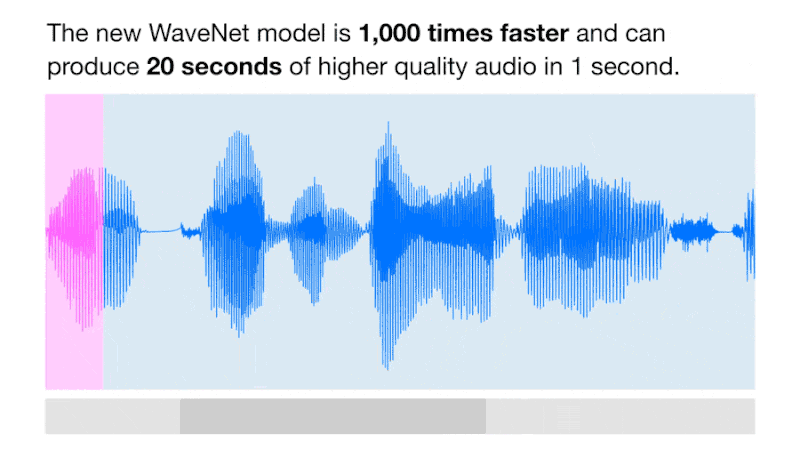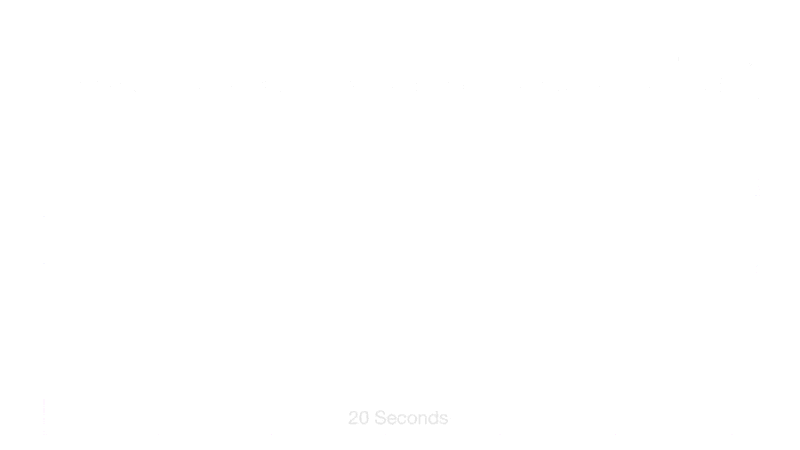
WaveNet змяніў параметрычную гісторыю, прадказваючы аўдыёсігнал па ўзорах замест таго, каб перадаваць кампактную спектраграму вакадэру. Праца Google 2016 года паказала, што пашыраная згортачная сетка можа ахопліваць тысячы часовых крокаў. Неапрацаваны гук мае шчыльнасць — звычайна 16 000 узораў у секунду і больш — таму аўтарэгрэсіўная генерацыя дарагая, але яна фіксуе прыцмокі і асаблівасці дынаміка, якія канкатэнацыя часта прапускае.
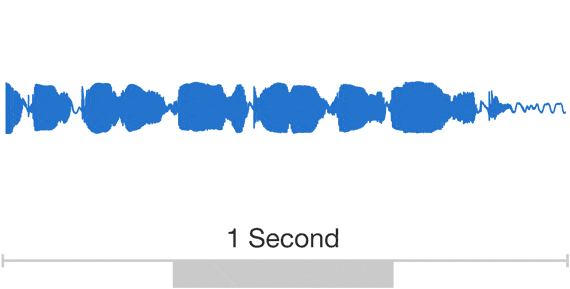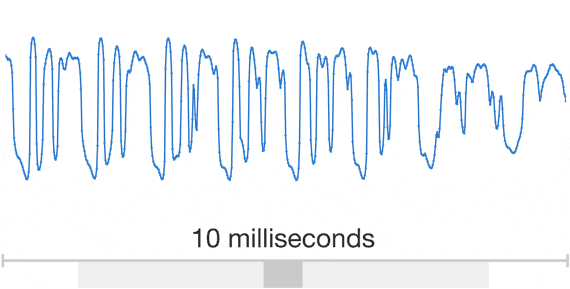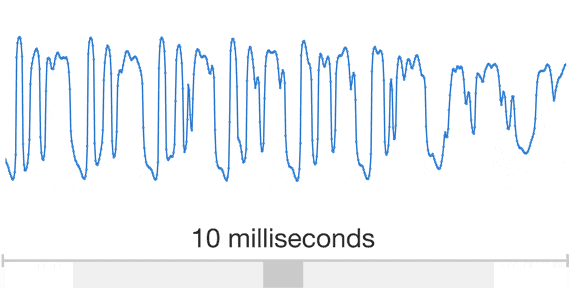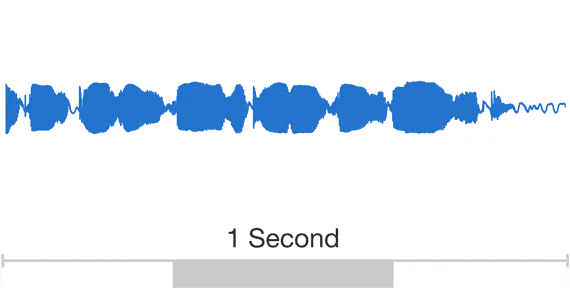
PixelRNN і PixelCNN паказалі, што генерацыя выявы па адным канале за раз магчымая. WaveNet — гэта аднамерная версія гэтай ідэі: цалкам згортачная сетка, каэфіцыенты дылатацыі якой экспанентна павялічваюць рэцэптыўнае поле.
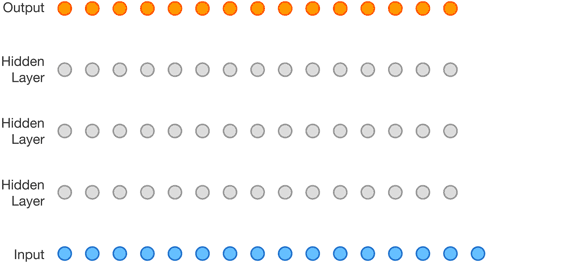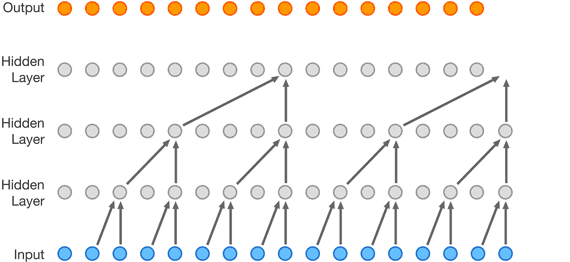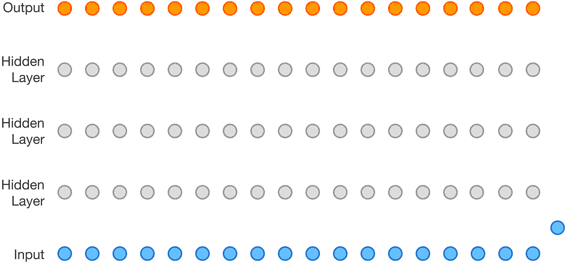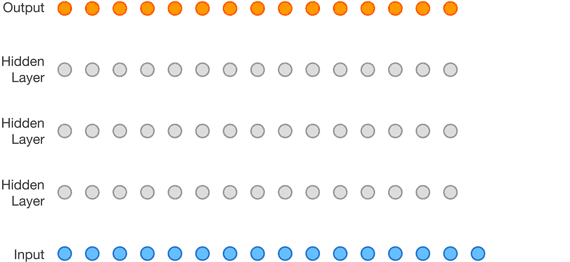
Падчас навучання ўваходнымі дадзенымі з'яўляюцца рэальныя запісаныя формы сігналаў. Падчас выбаркі кожны крок атрымлівае інфармацыю з прагназаванага размеркавання сеткі, вяртае гэтую выбарку назад і працягваецца. Менавіта гэты цыкл тлумачыць, чаму раннія вылічэнні WaveNet былі толькі для даследаванняў; пазнейшыя стэкі скарацілі іх да вытворчых Google TTS.
MOS і разрыў 2016 года
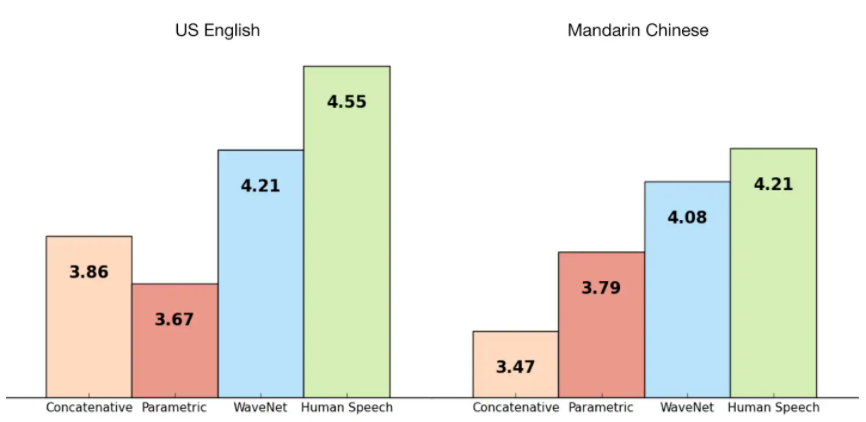
Ацэнка Google WaveNet супраць найлепшых на той момант параметрычных і канкатэнаваных сістэм з выкарыстаннем Сярэдні бал меркавання (MOS) — сляпыя ацэнкі людзьмі (больш за 500 ацэнак на 100 тэставых сказах у першапачатковай справаздачы). WaveNet скараціў пакінуты разрыў да чалавечага маўлення больш чым удвая для амерыканскай англійскай мовы і кітайскай мовы (мандарынскай) у гэтых тэстах. Гэта даследчы этап, а не маркетынгавы бал GSpeech.
WaveNet — гэта адно з сямействаў у Unified AI Voice Engine. Пазнейшыя стэкі — Gemini TTS, Чырп3 HD, Neural2, Polyglot і OpenAI — гэта тое, што вы выбіраеце ў якасці голасу ў Cloud Console. Вы не разгортваеце кантрольную кропку WaveNet на WordPress.
Gemini TTS: кіраванае маўленне
WaveNet прадказаў наступны аўдыёўзор. Gemini TTS — гэта пазнейшы шлях генерацыі маўлення ў Google: вы апісваеце, як павінен гучаць прачытаны тэкст на натуральнай мове — стыль, акцэнт, тэмп, тон, эмоцыі, падачу — і мадэль выконвае гэты кірунак. Вось чаму GSpeech карыстальніцкія галасавыя падказкі і Галасавыя вібрацыі (стылі, а не дадатковыя ідэнтыфікатары голасу) маюць значэнне на Gemini: элемент кіравання знаходзіцца ў камандным радку, а не ў новым канкатэнацыявым банку.
Спачатку ўсё ж адбываецца лінгвістычная ачыстка. Псеўданімы Smart Promoving могуць пашыраць акронім або блакіраваць токен брэнда; затым Gemini прамаўляе падрыхтаваны радок з запытанай дастаўкай. Афіцыйныя заўвагі API: Gemini TTS.
Найвышэйшая дакладнасць апавядання ў стылі Gemini, калі праслухоўванне з'яўляецца часткай старонкі: флагманскія паведамленні, тлумачэнні брэндаў, тэксты прадуктаў.
Тая ж мова падказак, што і ў Pro, настроеная для больш хуткай генерацыі па каталогу паведамленняў або SKU.
Gemini Pro
Gemini Pro — гэта ультрарэалістычная мадэль Gemini TTS у GSpeech. Вы пішаце ўласную галасавую падказку гэтак жа, як і апавядальніку: больш спакойнае тлумачэнне прадукту, больш яркі блог, больш выразны акцэнт, больш павольны тэмп, больш эмоцый. Бачны HTML застаецца чыстым для чытачоў і SEO. Няма асобнай клавішы Gemini, праекта Google AI Studio або дадатковай кансолі пастаўшчыка.
Тэхнічна гэта ўсё яшчэ воблачны сінтэз, а потым захаваны файл. Паўторныя праслухоўванні — гэта прайграванне, а не новае вяртанне ў Gemini. Выкарыстоўвайце Pro, калі гук з'яўляецца галоўным досведам — галоўны артыкул або старонка прадукту, дзе падача павінна адчувацца накіраванай, а не агульнай.
Gemini Flash
Gemini Flash — гэта тая ж сямейства Gemini TTS, створанае для хуткасці. Слоўнікавыя падказкі адпавядаюць Pro (стыль, акцэнт, тэмп, тон, эмоцыі, падача), таму вы можаце напісаць галасавую інструкцыю адзін раз і выкарыстоўваць яе паўторна, пакуль Flash хутчэй перагортвае старонкі. Працоўная машына каталога: шмат паведамленняў, апісанні WooCommerce, шматмоўныя чарнавікі. Павысьце галоўны URL у Pro, калі вам патрэбна апошняя частка прадукцыйнасці.
Chirp3 HD: Google Cloud’s current HD neural family
Chirp3 HD не з'яўляецца «WaveNet з новай назвай». WaveNet (2016) мадэляваў неапрацаванае аўдыё з дапамогай пашыраных звілін. Галасы Neural2, Polyglot і WaveNet усё яшчэ знаходзяцца ў каталогу Google Cloud ( 230 + паверх: Standard, WaveNet, Neural2, Polyglot, Journey, Studio, News). Chirp3 HD — гэта пазнейшае пакаленне высокадакладнага воблачнага TTS ад Google, створанае для рэалізму і натуральнай інтанацыі, а не для плоскага чытання ўслых. Афіцыйныя заўвагі: Чырп 3 HD.
Унутры GSpeech Chirp3 HD — гэта голас воблачнай кансолі: няма праекта Google Cloud, няма JSON з уліковага запісу службы. Вы выбіраеце голас; сінтэз выконваецца на аснове вашага паходжання; файл захоўваецца і прайграваецца праз поўную старонку, кнопку, круг, плаваючую кнопку, кантэкст або RHT. Хуткасць і вышыня застаюцца ў кансолі. Фірмовыя назвы ўсё яшчэ павінны быць у псеўданімах разумнага вымаўлення — гэты пласт не залежыць ад таго, якую сямейства Google вы абралі.
Калі выбіраць Chirp3 HD супраць Gemini: Chirp3 HD, калі вам патрэбна нейрафонная якасць Google Cloud HD і паслядоўнае чытанне, незалежнае ад прылады. Gemini Pro / Flash, калі вам патрэбны кантроль над стылем і эмоцыямі з дапамогай падказак на натуральнай мове. Абодва з'яўляюцца камерцыйнымі шляхамі Unified AI Voice Engine. Агульная колькасць рухавікоў складае 300+ галасоў праз 98 мовы (Gemini ~30 × 3 для Chirp 3 HD, Flash і Pro на мову, плюс OpenAI 11 × 2, плюс каталог Google Cloud). Галасавыя вібрацыі — гэта стылі, а не дадатковыя ідэнтыфікатары.
- Neural2 - шырока выкарыстоўваныя нейронныя галасы для вытворчасці ў тым жа каталогу Google Cloud.
- Паліглот - лепшая шматмоўная / міжмоўная прадукцыйнасць.
- WaveNet — сямейства неапрацаваных сігналаў 2016 года, усё яшчэ даступнае ў выглядзе галасоў каталога, а не адзіны шлях Google.
Уніфікаваны механізм штучнага інтэлекту (AI Voice Engine) супраць браўзернага TTS
Прылада speechSynthesis — гэта лакальны API. Галасы адрозніваюцца ў залежнасці ад аперацыйнай сістэмы. Няма файла «Згенераваць адзін раз, захаваць і прайграваць», няма сінхранізацыі Smart Audio Sync пры змене копіі CMS і няма падказкі Voice Vibes. GSpeech Cloud Processing запускае мадэль у воблаку, захоўвае файл, і віджэт прайгравае яго. Часовыя праблемы з генерацыяй не выдаляюць раней створаныя файлы. Файлы не выдаляюцца, калі ўліковы запіс вяртаецца да бясплатнага плана. Новая генерацыя працягваецца ў адпаведнасці з актыўным планам.
models:  "OpenAI, Gemini, Google Cloud, Chirp3 HD, Neural2, Polyglot, WaveNet"
langs:    "98 languages, 300+ voices (commercial)"
control: "Voice Vibes + Smart Pronunciation Aliases"
keys:    "No API Keys Required"
Голасавыя вібрацыі (камерцыйныя) выкананы ў стылі падказак, а не ў новым канкатэнацыявым банку. Псеўданімы выпраўляюць, як прамаўляецца токен, не змяняючы бачны HTML. Абодва з'яўляюцца кіруючымі пластамі паверх любой акустычнай мадэлі, абранай рухавіком для гэтага голасу.
Часта задаваныя пытанні па тэхналогіі пераўтварэння тэксту ў маўленне
Мадэлі і канвееры — не налада плагіна.
-
Ці выкарыстоўвае GSpeech WaveNet пры кожным праслухоўванні?
Не. WaveNet — гэта адна з сямействаў Google. Unified AI Voice Engine таксама выкарыстоўвае Neural2, Polyglot, Chirp3 HD, Gemini і OpenAI у залежнасці ад абранага вамі голасу. Функцыя «Згенераваць адзін раз, захаваць і прайграваць» азначае, што паўторныя прайграванні выкарыстоўваюць захаваны файл, а не новы цыкл узораў у стылі даследавання.
-
Чаму ўсё яшчэ згадваецца канкатэнацыя TTS?
Гэта гістарычная база: зшыванне запісаных адзінак. Нейронавыя мадэлі генеруюць аўдыё замест склейвання складоў. Разуменне канкатэнацыі ў параўнанні з WaveNet тлумачыць, чаму сучасныя камерцыйныя галасы могуць змяніць стыль без новага сеансу запісу.
-
Ці магу я запускаць гэтыя мадэлі на сваім уласным серверы?
Прадукт вэб-сайта GSpeech — гэта воблачная апрацоўка без нагрузкі на сервер. Вы не размяшчаеце WaveNet, Gemini або OpenAI на WordPress. Ключы API не патрабуюцца: аплата і ключы застаюцца ў воблачнай кансолі.
-
Ці распаўсюджваецца MOS 2016 года на GSpeech сёння?
Дыяграма MOS на гэтай старонцы — гэта апублікаваная Google ацэнка WaveNet. GSpeech не сцвярджае, што аднолькавая лічба для кожнага бягучага голасу. Бягучая камерцыйная якасць вызначаецца вышэйзгаданым спалучэннем рухавікоў, а не перадрукоўкай MOS 2016 года ў якасці ацэнкі прадукту.
-
Gemini Pro супраць Gemini Flash - у чым розніца?
Тое ж сямейства Gemini TTS і тая ж мова галасавых падказак (стыль, акцэнт, тэмп, тон, эмоцыі, падача). Flash хутчэйшы для каталогаў; Pro — гэта больш дакладны шлях для флагманскіх старонак. Ні для аднаго з іх не патрабуецца ключ Gemini API у GSpeech — вы выбіраеце голас у Cloud Console.
-
Ці з'яўляецца Chirp3 HD тым жа самым, што і WaveNet?
Не. WaveNet — гэта сямейства мадэляў неапрацаваных хвалевых формаў ад Google 2016 года. Chirp3 HD — гэта пазнейшае пакаленне высокадакладнага Cloud TTS для рэалізму і інтанацыі. Галасы Neural2, Polyglot і WaveNet усё яшчэ існуюць у каталогу Google Cloud (больш за 230). GSpeech прадстаўляе Chirp3 HD як кансольны голас без праекта Google Cloud.
Ад паперы да голасу ў кансолі
Канкатэнацыявыя банкі, параметрычныя вакодэры і стаўка WaveNet на неапрацаваныя формы сігналу — вось лінія. Gemini TTS (Pro / Flash) дадае кіраваную падказкамі дастаўку; Chirp3 HD — гэта бягучае сямейства нейронных HD ад Google Cloud. На сайце GSpeech вы чуеце бягучы Unified AI Voice Engine праз віджэт — «Поўная старонка», «Кнопка», «Круг» або… Чытаць вылучаны тэкст (RHT) — з файламі, якія захоўваюцца пасля першай генерацыі. Каб даведацца, ці павінен мой URL-адрас мець прайгравальнік, скарыстайцеся артыкулам пра перавагі. Для клікаў wp-admin скарыстайцеся кіраўніцтвам.
